RDMA 학습 시리즈 (1/7). 실제 S3-over-RDMA 검증 환경의 실측 기반 학습 자료입니다.
RDMA(Remote Direct Memory Access)는 원격 노드의 메모리를 CPU와 커널의 개입 없이 직접 읽고 쓰는 기술입니다. 이 약속을 지키는 주체는 소프트웨어가 아니라 하드웨어입니다. 패킷을 커널로 올리지 않고 카드 자체에서 처리하는 RDMA NIC, 그리고 그 카드들을 잇는 무손실 패브릭 — 시리즈 첫 편에서는 이 물리적 바닥부터 다룹니다.
왜 하드웨어부터 시작할까요. 나중에 만나게 될 verbs 함수 하나, LID 주소 하나, MTU 숫자 하나가 전부 실제 부품의 능력과 제약 위에 서 있기 때문입니다. 바닥의 부품을 읽으면 위의 추상화가 전부 이해됩니다. 반대로 부품을 모르면 모든 오류 메시지가 암호로만 남습니다.
이 글의 실측값은 내부 검증 클러스터에서 나왔습니다. GPU 노드(gpu-1)가 스토리지 게이트웨이(stg-node1/2) 위의 Lustre 볼륨을 RDMA로 직접 읽는 S3-over-RDMA 검증 환경으로, LID·MTU·BAR1 경계 같은 숫자는 이 환경에서 측정된 값을 그대로 인용합니다.
TL;DR
- RDMA NIC(HCA)은 연결 상태(QP)와 메모리 변환표(MTT)를 카드 안에 스스로 보관하는 능동 장치다 — 커널 바이패스의 물리적 근거
- ConnectX-4부터 세대가 달라도 mlx5 공통 드라이버로 묶인다 — 디바이스는
mlx5_0,mlx5_1처럼 PCI 탐색 순서대로 번호가 붙는다 - SR-IOV VF는 링크 타입(InfiniBand/Ethernet)을 PF에서 상속한다 — 게스트 안에서는 바꿀 수 없다
- GPUDirect의 관문은 BAR1과 peermem — RTX A6000(BAR1 256 MiB)에서 192 MiB 전송까지 성공, 224 MiB부터 실패 실측
- IB 스위치는 credit 기반 흐름제어로 패킷 드롭 자체가 없다 — SM이 LID와 라우팅 테이블(LFT)을 배포한다
- QSFP28의 4레인 집선이 EDR 100Gb/s를 만든다 — 검증 패브릭의 링크·IPoIB MTU는 모두 4096
1. RDMA NIC(HCA)란 무엇인가
RDMA는 이름 그대로 원격 노드의 메모리를 CPU와 커널의 개입 없이 직접 읽고 쓰는 기술입니다. 이 약속을 지키려면 패킷을 커널로 올리지 않고 카드 자체에서 처리하는 전용 하드웨어가 필요한데, 그것이 RDMA NIC입니다. InfiniBand 세계에서는 HCA(Host Channel Adapter)라고 부릅니다.
일반 NIC이 “도착한 패킷을 커널에 전달하는” 수동적인 장치라면, RDMA NIC은 자체 프로세서와 RDMA 엔진을 갖추고 연결 상태(QP, 큐 페어)와 메모리 변환표(MTT)를 스스로 보관하는 능동적인 장치입니다. 아래 그림이 카드 내부의 데이터 경로를 보여줍니다.
일반 NIC과의 차이 — 커널 바이패스
같은 “네트워크 카드”라도 데이터가 흐르는 길이 근본적으로 다릅니다. 일반 NIC은 모든 패킷을 커널 소켓 버퍼로 올린 뒤 애플리케이션으로 복사하지만, RDMA NIC은 등록된 사용자 공간 버퍼를 MTT로 추적하다가 처음부터 애플리케이션 버퍼에 직접 씁니다.
| 구분 | 일반 NIC | RDMA NIC (HCA) |
|---|---|---|
| 데이터 경로 | NIC → 커널 소켓 버퍼 → 앱으로 복사 | NIC → 앱 버퍼 직접 DMA (커널 미경유) |
| CPU 개입 | 패킷마다 커널 처리·문맥 전환 | 온보드 RDMA 엔진이 오프로드 — 완료만 통지 |
| 연결 상태 보관 | 커널 TCP/IP 스택 | NIC 내부(QP 컨텍스트 캐시) |
| 전송 신뢰성 | 소프트웨어(TCP 재조립) | 하드웨어(RC 등 서비스 레벨) |
| 지연·CPU 부하 | 상대적으로 높음 | 낮음 — 소프트웨어 스택을 건너뛰므로 |
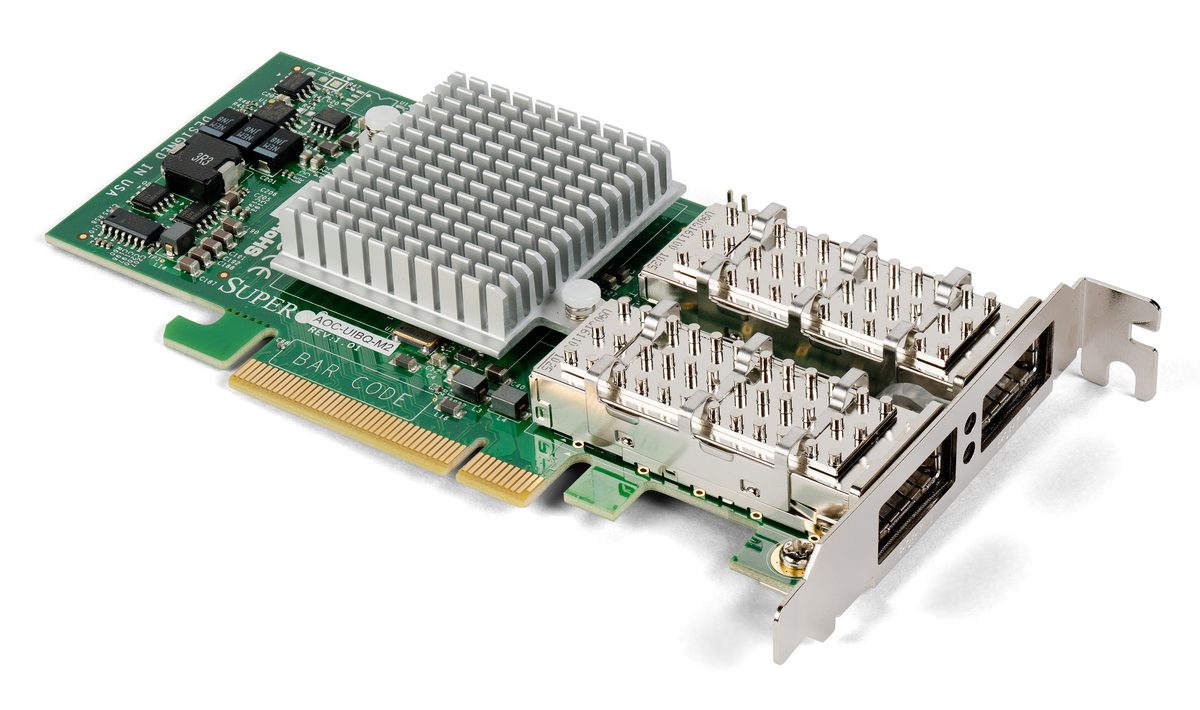
실물 HCA는 아래와 같이 생겼습니다. QSFP 커넥터(패브릭측)와 PCIe 카드 엣지(호스트측)가 한 장의 카드에 함께 있습니다 — 그림 1의 좌우 끝이 물리적으로 이 모양입니다.
핵심 용어
- HCA (Host Channel Adapter) — InfiniBand 용어로 부르는 RDMA NIC. “호스트를 패브릭에 연결하는 어댑터”라는 뜻이 담겨 있다. 이 시리즈에서는 NIC과 같은 대상을 가리킨다.
- NIC (Network Interface Card) — 네트워크 인터페이스 카드의 일반 명칭. 문맥에 따라 일반(비-RDMA) 카드를 가리킬 때도 있으므로 앞뒤 문맥으로 구분한다.
- PCIe — NIC과 호스트 CPU·메모리를 잇는 버스. ConnectX-4 기준 Gen3 ×16. RDMA의 “빠름”은 패브릭 포트만큼이나 이 호스트측 버스 대역폭에도 좌우된다.
- DMA (Direct Memory Access) — CPU 개입 없이 장치가 메모리를 직접 읽고 쓰는 전송 방식. RDMA NIC은 호스트 메모리뿐 아니라 원격 노드의 메모리까지 DMA 대상으로 삼는다.
- 커널 바이패스 (kernel bypass) — 데이터가 커널을 거치지 않고 사용자 공간 버퍼와 NIC 사이를 직통하는 것. 복사와 문맥 전환이 사라져 지연이 크게 줄어든다. RDMA 성능 이점의 핵심.
2. ConnectX 제품 계보와 mlx5
데이터센터 RDMA NIC의 사실상 표준은 NVIDIA(Mellanox 인수)의 ConnectX 계열입니다. 세대가 오를수록 포트 대역폭과 오프로드 기능이 늘어왔고, 소프트웨어는 ConnectX-4부터 mlx5라는 공통 코어 드라이버로 통일됐습니다.
| 세대 | 출시 | 포트당 대역폭 | 주요 특징 |
|---|---|---|---|
| ConnectX-3 | 2013 | FDR 56Gb/s | PCIe Gen3, mlx4 드라이버 |
| ConnectX-4 | 2014~15 | EDR 100Gb/s | InfiniBand + RoCE v1/v2, mlx5 도입 — 이 시리즈 1차 검증의 하드웨어 |
| ConnectX-5 | 2016 | 100/200Gb/s | 향상된 오프로드(추가 엔진) |
| ConnectX-6 Dx | 2020 | 200/400Gb/s | IPsec·TLS 하드웨어 암호화 |
| ConnectX-7 | 2021 | 400Gb/s | NVLink·스케일업 패브릭 확장 |
mlx5 드라이버와 디바이스 명명
ConnectX-4 이후의 카드는 리눅스에서 mlx5 코어 드라이버로 묶입니다. 시스템에 장착된 RDMA 디바이스는 PCI 탐색 순서대로 mlx5_0, mlx5_1 …처럼 번호가 붙고, 사용자 공간 애플리케이션(verbs)은 각 디바이스에 대응하는 /dev/infiniband/uverbs 장치 파일로 접근합니다.
# RDMA 디바이스 확인 — 검증 노드(node-a) 기준
ibv_devices                 # 장치 목록: mlx5_0, mlx5_1
ibstat mlx5_0               # 포트 상태 · 링크 레벨 · LID · MTU 확인
ls /dev/infiniband/         # uverbs0, uverbs1 — RDMA 디바이스당 하나
검증 환경(1차, CX4 VF) — 클라이언트 노드(node-a)는 ConnectX-4 VF 2개(ib0/ib1)에 MLNX_OFED 24.10-3.2.5.0 스택, 스토리지 노드(node-b/node-c)는 배포판 내장(inbox) verbs로 구성됐다. 이기 스택 조합에서도 표준 verbs 기반 전송은 양쪽 모두 동작했다. 이 시리즈가 인용하는 1차 실측값(LID 0x3FA, MTU 4096 등)은 이 환경에서 나온 것이다.
3. SR-IOV — PF와 VF
가상화 서버 한 대에 RDMA NIC을 통째로 붙여 주는 대신, 여러 게스트에게 나눠 주는 표준 기술이 SR-IOV(Single Root I/O Virtualization)입니다. 하이퍼바이저가 소유한 물리 기능 PF(Physical Function)가 경량 가상 기능 VF(Virtual Function)을 여러 개 만들어 내고, 각 VF를 PCIe 패스스루로 게스트 VM에 직접 할당합니다. 게스트 입장에서 VF는 자기 전용 NIC 그 자체입니다 — 자체 드라이버(mlx5)가 붙고 자체 디바이스 파일이 생깁니다.
mlx5_0으로 보이며 ib0(172.16.44.40, LID 0x3FA)로 활성화됐다.VF는 링크 타입을 PF를 따른다
VF는 “카드를 쪼갠 조각”이므로 링크 모드(InfiniBand/Ethernet)를 스스로 정할 수 없고 호스트 PF의 설정을 상속합니다. 이 제약이 1차 검증 전체의 출발점이 됐습니다.
VF 링크 타입의 함정 — “NIC은 모두 ConnectX-4 Virtual Function(SR-IOV) — 링크 타입은 호스트 PF를 따르므로 현재 IB 모드 고정. 링크 모드 전환은 호스트(PVE) 작업이 필요해 이 검증에서는 불가능했다. 그래서 ‘IB 그대로에서 되는 방법’을 찾는 것이 과제였다.” (검증 기록 §2)
게스트 안에서 이것을 바꿀 방법은 없습니다. RoCE로 바꾸고 싶어도 PVE 호스트에서 PF 설정을 바꿔야 합니다 — 가상화 환경에서 RDMA를 다룰 때 반드시 먼저 확인해야 할 사항입니다.
node-a 노드의 VF 구성 (1차 실측)
| 디바이스 | 인터페이스 | 상태 |
|---|---|---|
mlx5_0 (VF 0) | ib0 · 172.16.44.40/24 (IPoIB) | 사용 중 — LNet o2ib 등록, LID 0x3FA, MTU 4096 |
mlx5_1 (VF 1) | ib1 | 미사용 — LNet 등록 거부(“couldn’t query intf”, 원인 미규명) |
핵심 용어
- SR-IOV (Single Root I/O Virtualization) — PCIe 표준의 장치 가상화 기능. 하나의 물리 장치를 여러 가상 기능으로 쪼개 게스트에 거의 네이티브 성능으로 나눠 주는 메커니즘.
- PF (Physical Function) — 완전한 기능을 가진 물리 PCIe 기능. 하이퍼바이저가 소유하며 VF 생성·삭제와 물리 포트·링크 설정을 관장한다.
- VF (Virtual Function) — PF가 만들어내는 경량 가상 기능. 자체 PCI 식별자와 리소스(큐)를 가지며 게스트에 패스스루된다. 링크 타입 등 카드 전역 설정은 PF를 따른다.
- 패스스루 (passthrough) — 호스트를 거치지 않고 VF를 게스트 VM에 직접 할당하는 것. 게스트는 VF를 자기 하드웨어로 인식하며 데이터 경로가 하이퍼바이저를 우회한다.
- PVE (Proxmox Virtual Environment) — 검증 클러스터가 사용한 하이퍼바이저. PF를 소유한 주체로서 링크 모드 전환 같은 호스트 작업의 소관이다.
4. GPU와 RDMA — GPUDirect
GPU 연산 결과를 네트워크로 보낼 때도 커널 바이패스의 논리가 그대로 적용됩니다. 기본 경로에서는 GPU 메모리의 데이터를 한 번 호스트 메모리로 복사한 뒤 NIC으로 보내지만, GPUDirect 계열 기술은 GPU 메모리에 피니드(pinned) 버퍼를 두고 NIC이 그 버퍼로 직접 DMA하게 합니다. 스토리지 대상은 GPUDirect Storage(GDS), 원격 노드 대상은 GPUDirect RDMA로 불립니다.
| 구분 | 일반 경로 (복사 후 전송) | GPUDirect (직접 DMA) |
|---|---|---|
| 데이터 경로 | GPU 메모리 → 호스트 피니드 메모리(복사) → NIC | GPU 피니드 메모리 → NIC 직접 DMA |
| 호스트 메모리 경유 | 필요 — 사본이 한 벌 더 생김 | 불필요 |
| PCIe 트래픽 | GPU→호스트 + 호스트→NIC (2회 통과) | GPU↔NIC (1회 통과) |
| CPU 개입 | 복사마다 CPU 참여 | 최소화 — 지시만 하면 나머지는 장치들이 처리 |
대규모 시설에서 GPU와 RDMA 패브릭의 결합은 이미 표준 아키텍처입니다. 아래 NASA Pleiades 슈퍼컴퓨터 사진이 그 규모의 실례를 보여줍니다.
검증 — GPU-direct 경로의 실측
2차 검증에서는 NVIDIA 경로를 끝까지 통과시켰습니다. 클라이언트 gpu-1은 RTX A6000 GPU(BAR1 256 MiB)에 ConnectX-6(mlx5_0, 200G HDR, LID 13, GID idx0)을 짝지은 노드입니다. GPU↔NIC는 PCIe Gen4 ×16, 위상 PHB(호스트 브리지 경유)로 연결됐습니다. 게이트웨이 stg-node1/2(CX6 ×2, LID 12/11)가 Lustre /vol0을 받칩니다. 그림 6이 이 경로 전체를 그립니다.
mlx5_0, 200G HDR·LID 13·GID idx0)이 PCIe Gen4 ×16(위상 PHB)로 읽고 쓴다. ② 초록 — IB 패브릭 링크(HDR 200G, SM lid 8·MTU 4096)를 지나 게이트웨이 stg-node1/2(CX6 ×2·LID 12/11)와 Lustre /vol0에 닿는다. ③ 빨강 — BAR1 실패 경계: BAR1 창 256 MiB(NVML 실측)에서 64 MiB 등록·192 MiB 전송은 성공하고 224 MiB부터 실패. H100(BAR1 128 GiB)은 이 한계에 해당하지 않는다.경로가 성립하려면 NIC이 GPU 메모리를 직접 보아야 합니다. cuFile은 nvidia_peermem 커널 모듈로 GPU HBM 영역을 RDMA에 등록하는데, 로그의 mr_size: 67108864가 64 MiB 등록의 흔적입니다. 이 매핑이 통과하는 관문이 BAR1 — GPU 메모리를 PCIe 공간에 내미는 창입니다. RTX A6000의 BAR1은 256 MiB라서 실측도 그 선에서 갈렸습니다. 192 MiB 전송까지 OK, 224 MiB부터 실패(256 MiB 요청은 cuMemObjGetDescriptor rc=1, “BAR 1 size detected via NVML API: 256 MiB”). BAR1이 128 GiB급인 H100 같은 데이터센터 GPU에는 이 한계가 해당하지 않습니다. 안내는 한 줄이면 족합니다 — GPU-direct 전송 크기는 BAR1 여유 이하로.
peermem 개통의 로그(실측) — 클라이언트(gpu-1)의 cufile.log:
nvidia_peermem is enabled·register with RDMA success mr_size: 67108864(GPU HBM 64 MiB RDMA 등록) — 그림 6의 파란 경로가 살아 있다는 직접 증거다. “Userspace RDMA: Supported · Mellanox PeerDirect: Enabled”까지 확인됐다. GPU-direct는 소프트웨어 요건(peermem/dma-buf)과 하드웨어 요건(PCIe 위상·BAR1)이 동시에 충족될 때 열린다(3편·8편).
이 절에서는 하드웨어 관점 — PCIe 위상·BAR1·peermem — 만 짚었습니다. 이 경로가 소프트웨어 스택의 어떤 계층을 지나는지는 3편(소프트웨어 스택)에서 다시 다룹니다.
5. IB 스위치와 서브넷 매니저(SM)
노드가 두 대뿐이라면 케이블로 직접 연결해도 되지만, 실제 패브릭은 스위치를 중심으로 구성됩니다. InfiniBand 스위치는 겉모습이 이더넷 스위치와 비슷합니다 — 앞면에 QSFP 포트가 촘촘히 달린 1U 박스입니다. 그러나 속을 들여다보면 철학이 완전히 다릅니다. 패킷을 버리지 않는다는 것이 설계의 출발점입니다.
스위치 내부 — 포트, 크로스바, credit 버퍼
스위치에 패킷이 들어오면 포트가 신호를 받아 크로스바(crossbar)라는 교차 회로망이 임의의 포트쌍을 직접 이어줍니다. 여러 쌍이 동시에 지나가도 서로 다른 경로를 쓰므로 한 통신이 다른 통신을 밀어내지 않습니다. 그리고 각 포트에는 버퍼가 붙어 있는데, 이 버퍼가 IB와 이더넷이 갈리는 지점입니다.
IB의 버퍼는 credit 기반 흐름제어를 합니다. 수신 측이 “이만큼 더 받을 수 있다”는 크레딧을 미리 알려주면, 송신 측은 크레딧이 있는 만큼만 보냅니다. 버퍼가 가득 찰 상황 자체가 일어나지 않으므로 패킷이 드롭되지 않습니다. 이 무손실성이야말로 RDMA의 하드웨어 신뢰성(1절의 “전송 신뢰성 = 하드웨어”)을 지탱하는 물리적 기반입니다. 스위치의 ARM CPU는 이 데이터 경로와 분리된 제어 평면으로, 관리 쿼리(SMA 응답) 같은 일을 처리합니다.
이더넷 스위치는 정반대의 길을 택했습니다 — 버퍼가 차면 프레임을 버리고, 잃어버린 데이터는 상위 계층의 TCP 재전송이 복구합니다.
| 구분 | 이더넷 스위치 | IB 스위치 |
|---|---|---|
| 혼잡 시 동작 | 버퍼 오버플로 시 프레임 드롭 | 크레딧이 소진되기 전에 송신을 멈춤 — 드롭 자체가 없음 |
| 흐름제어 주체 | 상위 계층(TCP 재전송), 무손실화하려면 PFC 등 추가 구성 | 링크 단위 하드웨어 크레딧 — 기본 동작 |
| 재전송 | 소프트웨어 스택이 수행 | 불필요 — 무손실이 설계 전제 |
| 지연 변동 | 드롭·재전송으로 지터 발생 | 일정 — RDMA의 낮은 지연 뒷받침 |
서브넷 매니저 — LID 할당과 라우팅 테이블
스위치가 “길”이라면, 길에 이름을 붙이고 지도를 그리는 주체가 SM(Subnet Manager)입니다. 패브릭이 켜지면 SM은 서브넷 전체를 스캔하고 두 가지 일을 합니다.
- LID 할당 — 모든 포트에 16비트 로컬 식별자 LID(Local Identifier)를 부여한다. 패킷은 목적지 LID를 달고 다닌다.
- 라우팅 테이블 계산·배포 — “이 LID는 몇 번 포트로 가라”는 포워딩 테이블(LFT)을 계산해 모든 스위치에 내려보낸다. 스위치는 LFT를 따라 패킷을 다음 홉으로 전달한다.
SM은 전용 장비일 수도 있고 노드에서 돌아가는 소프트웨어일 수도 있는데, 대표적인 오픈소스 구현이 opensm입니다. 서브넷마다 마스터 SM은 하나뿐이며 나머지는 대기합니다.
검증 패브릭에도 SM이 살아 있었다는 흔적이 남아 있습니다 — ibstat가 보여준 node-a = LID 0x3FA, node-b = LID 0x494. LID는 SM이 할당하는 값이므로, 노드에서 LID가 보인다는 것 자체가 “패브릭 초기화가 정상적으로 완료됐다”는 증거입니다. LID가 이후 어떤 역할을 하는지(GID와의 관계, RC 연결의 주소 좌표)는 2편에서 다룹니다.
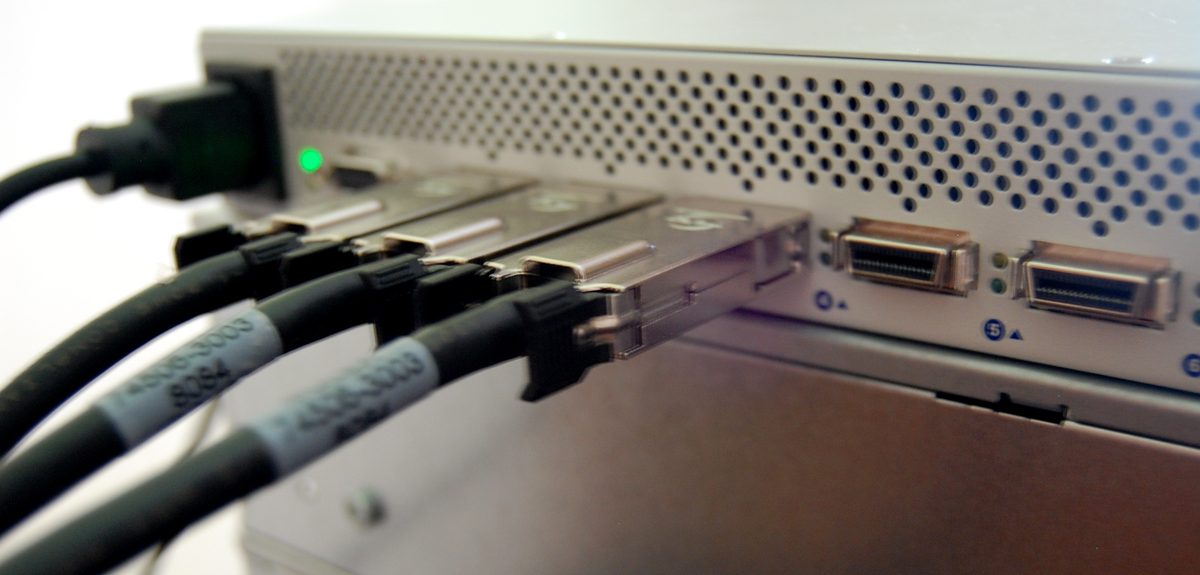
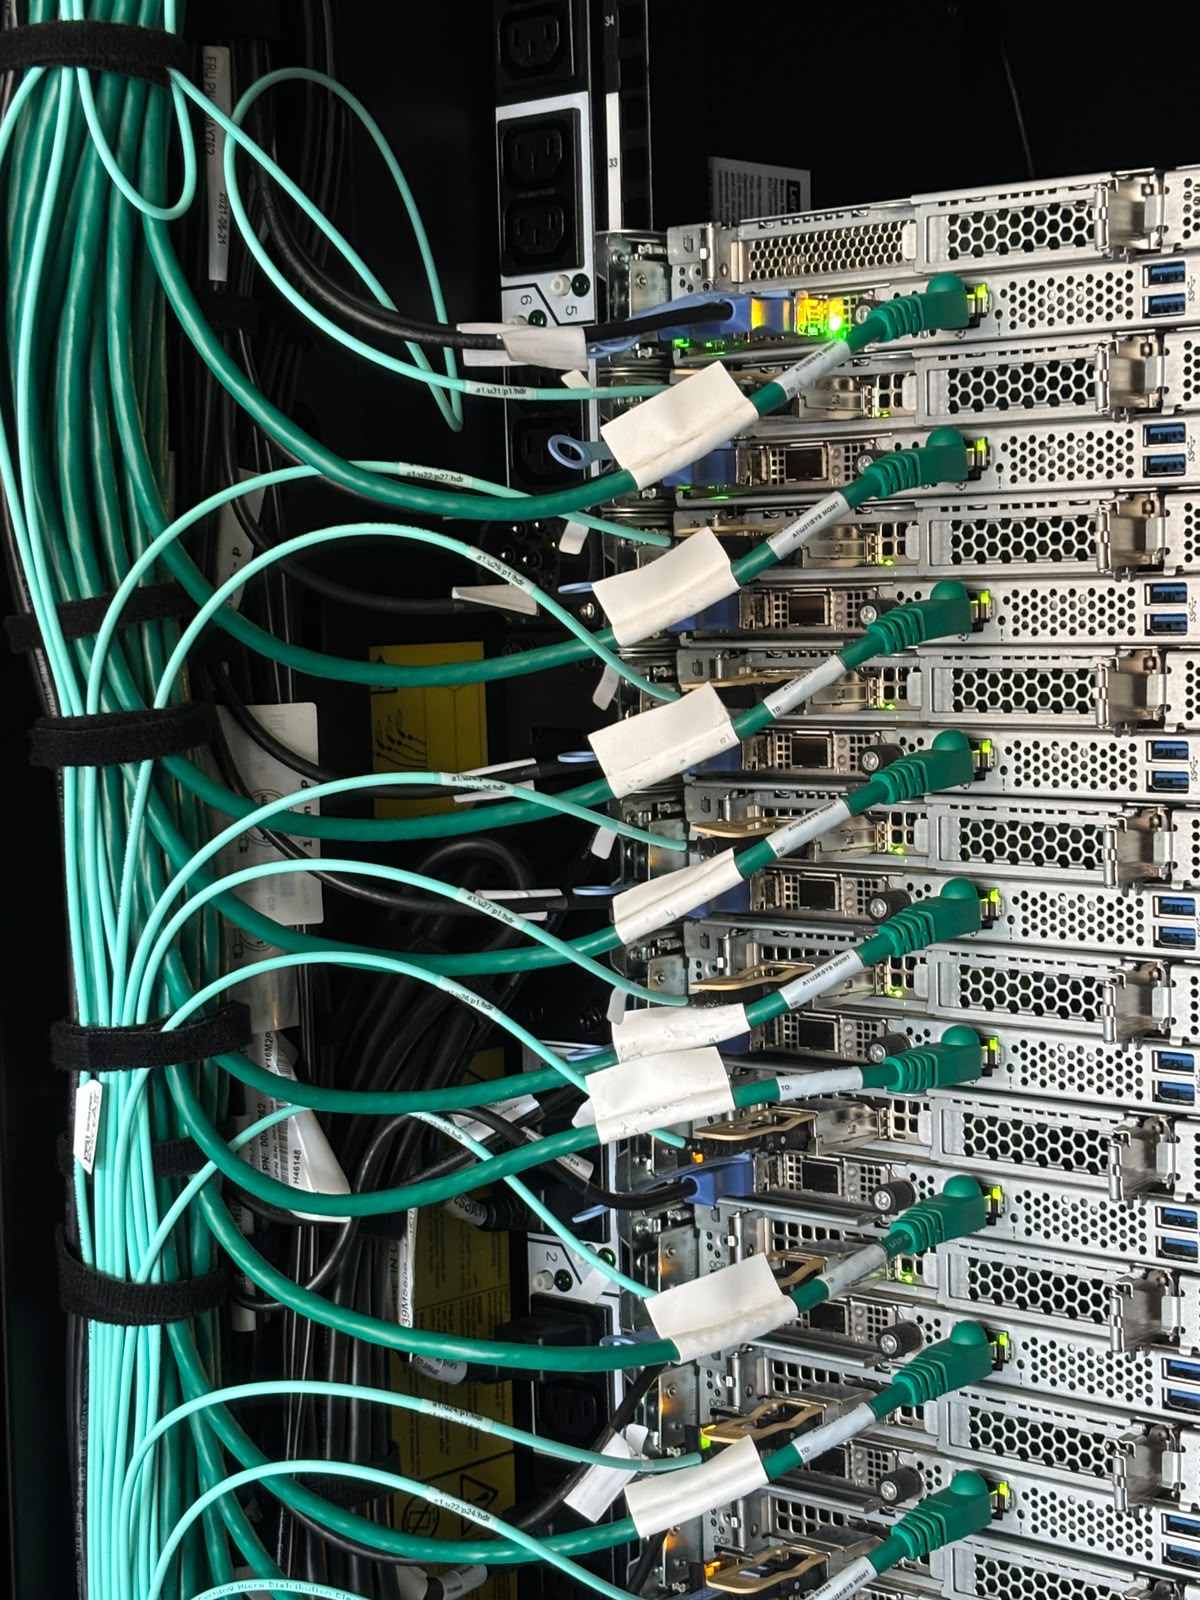
실물 스위치는 아래와 같습니다. 전면 포트에 꽂힌 케이블 하나하나가 그림 7의 “포트” 블록이고, 케이블 반대쪽은 각 노드의 HCA(그림 2)입니다.
핵심 용어
- 크로스바 (crossbar) — 임의의 입력 포트를 임의의 출력 포트에 동시에 접속시키는 교차 회로망. 여러 포트쌍의 통신이 독립 경로를 써서 서로를 방해하지 않게 한다.
- credit 기반 흐름제어 — 수신 측의 잔여 버퍼를 크레딧으로 알려주고, 송신 측이 크레딧 범위 안에서만 보내는 링크 단위 흐름제어. 버퍼 오버플로·드롭을 원천적으로 막는다.
- SM (Subnet Manager) — 서브넷 전체를 관리하는 소프트웨어. 패브릭 스캔, LID 할당, 라우팅 테이블(LFT) 계산·배포를 담당한다. 마스터는 서브넷에 하나.
- LID (Local Identifier) — SM이 각 포트에 할당하는 16비트 주소. 패킷의 홉-by-홉 전달 근거로 쓰인다. 실측 예: node-a = 0x3FA, node-b = 0x494.
- LFT (Linear Forwarding Table) — 스위치가 보유하는 “LID → 출력 포트” 포워딩 테이블. SM이 계산해 배포한다.
- opensm — 오픈소스 Subnet Manager 구현. 노드에서 실행해 패브릭을 초기화할 수 있다.
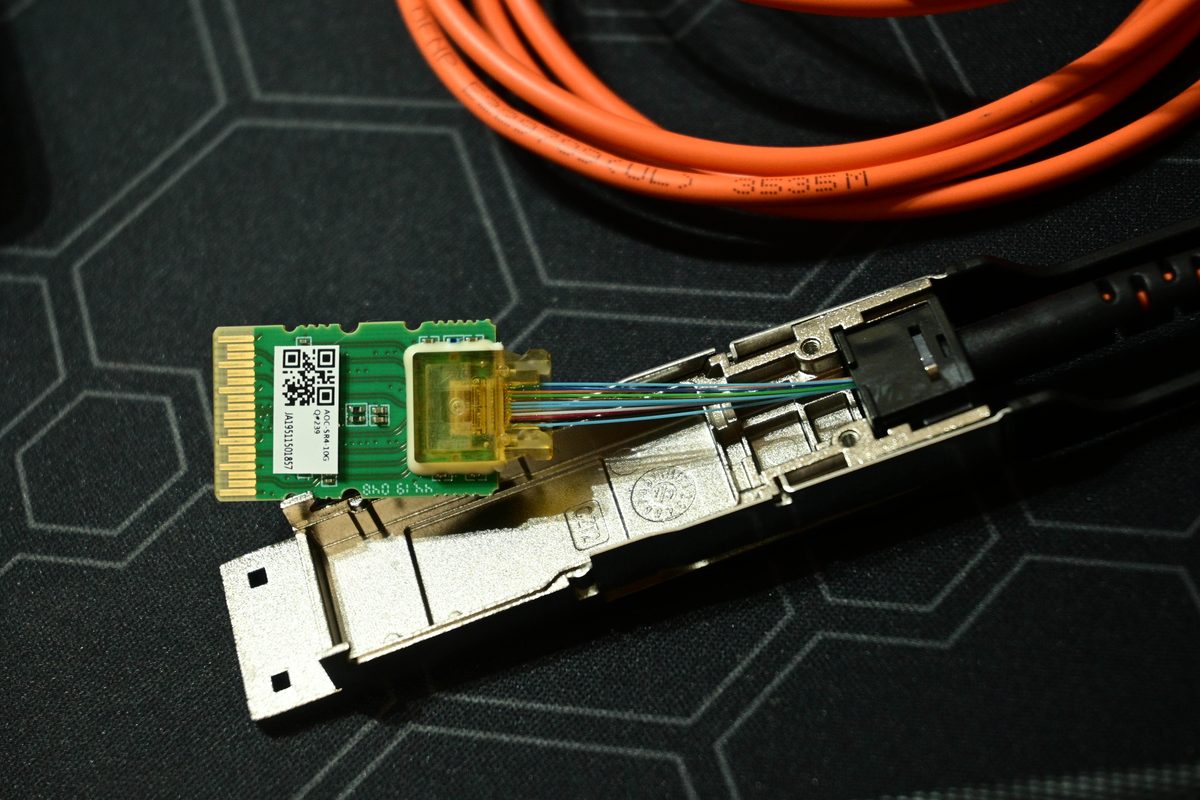
6. 케이블과 커넥터 — QSFP·트윈액스·광
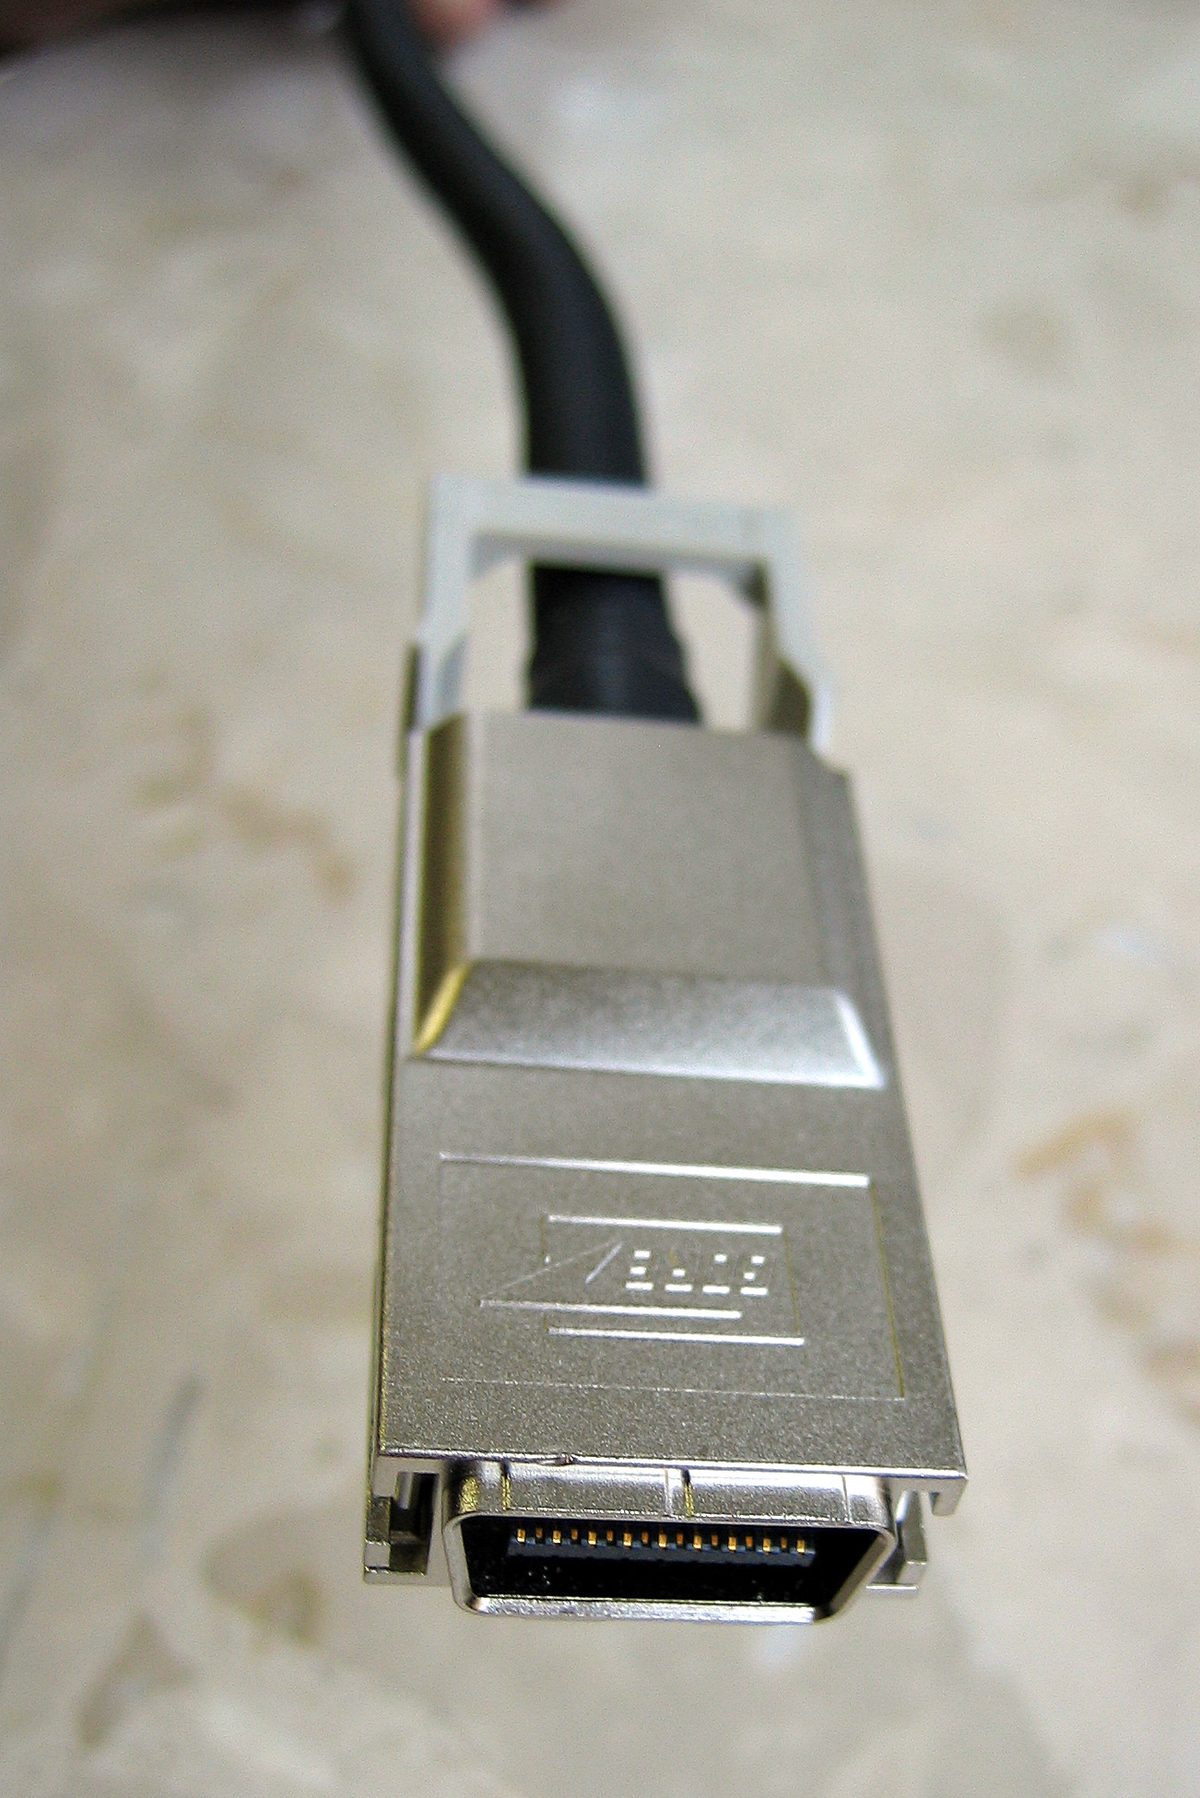
그림 1에서 HCA의 왼쪽 끝, 그림 8에서 스위치의 앞면을 차지하던 것이 바로 이번 절의 주인공입니다. RDMA의 “빠름”은 결국 커넥터 접점에서 오가는 전기 신호로 물리적으로 구현됩니다.
QSFP 폼팩터 — 4레인 집선
QSFP(Quad Small Form-factor Pluggable)는 신호를 4개의 차동쌍, 즉 4레인으로 나눠 보내는 커넥터 계열입니다. 한 줄을 아주 빠르게 만들기보다 여러 줄을 병렬로 묶는 집선 방식인데, 접점 하나가 담당하는 속도를 낮춰 신호 무결성을 확보하는 트레이드오프입니다. 세대에 따른 계산은 간단합니다.
- QSFP+ — 4 × 10 Gb/s = 40 Gb/s (QDR 세대)
- QSFP28 — 4 × 25 Gb/s = 100 Gb/s (EDR — 1차 검증의 ConnectX-4 링크)
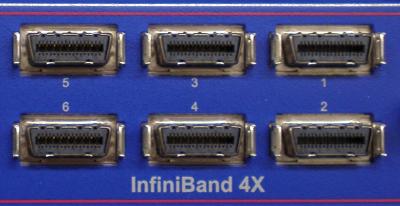
계보도 같은 맥락입니다. 구형 InfiniBand가 쓰던 CX4 커넥터(SDR/DDR 시절의 4X 연결)가 QSFP+를 거쳐 QSFP28로 이어지면서 “4레인 병렬”이라는 뼈대는 그대로 계승됐고, 폼팩터가 작아지고 밀도만 올라갔습니다. 그래서 QSFP 계열은 핀 배열이 세대를 넘어 호환되는 공통 언어에 가깝습니다.
트윈액스(구리) vs 광(AOC)
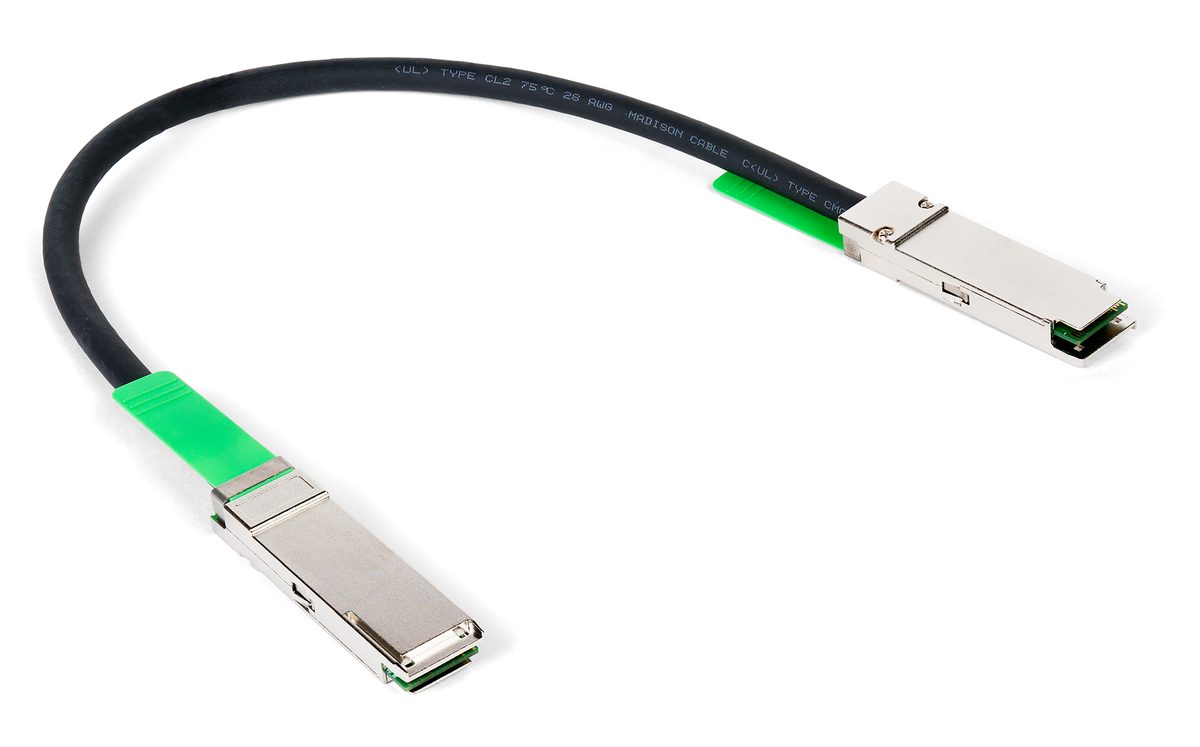
같은 QSFP28 커넥터라도 그 안을 무엇으로 채우느냐가 케이블 선택의 문제입니다. 짧으면 구리, 길면 광.
| 구분 | 트윈액스 (DAC) | AOC · 광 트랜시버 |
|---|---|---|
| 매체 | 구리 도선 4쌍 (수동/능동) | 광섬유 — 커넥터 끝에서 전기 → 광 변환 |
| 도달 거리 | 짧음 — 랙 내·인접 랙 (~2–3m) | 김 — 수m부터 100m 이상 (랙간·먼 노드) |
| 전력·비용 | 낮음 — 변환 칩이 없거나 간단 | 상대적으로 높음 — 양단에 변환 칩(광모듈) |
| 선택 기준 | 같은 랙 안 노드·스위치 연결 | 랙 간 배선·장거리 패브릭 |
MTU 4096의 맥락
검증 실측에서 링크 MTU는 4096이었습니다(ibstat의 링크 계층 항목). 이더넷의 전통적 기본값 1500과 비교하면 훨씬 큰 프레임입니다. RDMA는 한 번의 전송 지시로 큰 데이터 덩어리를 옮기므로, 프레임이 클수록 프레임당 헤더·처리 오버헤드가 얇아져 전송 효율이 올라갑니다. IPoIB 인터페이스(ib0)의 MTU도 같은 4096으로 설정돼 있었습니다 — 172.16.44.x망 전체가 큰 프레임으로 통일돼 있었던 셈입니다.
아래 사진들이 이 절의 실물 자료입니다.
핵심 용어
- QSFP / QSFP28 — 4차동쌍(4레인)을 수용하는 커넥터 폼팩터. QSFP+는 4×10G, QSFP28은 4×25G로 집선해 EDR 100Gb/s 링크를 만든다.
- 레인 (lane) — 한 쌍의 차동 신호선이 담당하는 전송 단위. QSFP28 기준 1레인 = 25 Gb/s.
- 트윈액스 (twinax, DAC) — 구리 도선쌍을 쓰는 케이블. 수동(DAC)과 능동(구간 증폭)이 있고, 짧은 거리에서 저전력·저가로 쓰인다.
- AOC (Active Optical Cable) — 양 끝 커넥터에 전기→광 변환 칩을 넣고 광섬유로 연결한 케이블. 장거리 전송용.
- CX4 — 구형 InfiniBand(SDR/DDR)의 4X 커넥터. QSFP+ → QSFP28로 이어지는 4레인 계보의 출발점.
- MTU (Maximum Transmission Unit) — 한 프레임이 실을 수 있는 최대 페이로드. 검증 패브릭은 링크·IPoIB 모두 4096으로 실측됐다.
7. 검증 환경 하드웨어 총정리
1절에서 배운 부품들이 검증 환경에 정확히 어디에 어떻게 쓰였는지 한 장으로 묶습니다. 구성표는 2차 검증(CX6 네이티브 IB)의 환경입니다. 이 구성을 기억하면 이후 편들(패브릭·소프트웨어 스택·구현)에서 등장하는 모든 실측값의 무대를 한눈에 떠올릴 수 있습니다.
검증 환경 구성표 (2차 — CX6 네이티브 IB)
| 노드 | 역할 | 주요 구성 |
|---|---|---|
| gpu-1 (10.0.0.193) | S3/cuObject 클라이언트(GPU-direct) | Rocky 9.8(검증 커널 5.14.0-570.32.1.el9_6) · ConnectX-6 mlx5_0 · 200G HDR · LID 13 · IPoIB 100.64.33.192 · RTX A6000(BAR1 256 MiB) · 드라이버 610.43.02(CUDA UMD 13.3) · GPU↔NIC 위상 PHB(PCIe Gen4 ×16) |
| stg-node1 · stg-node2 (10.0.33.243 / .244) | 게이트웨이(vgwrdma) + Lustre /vol0 (stg-node1은 MGS·MDT0·OST0 겸함) | Rocky 8.10 · ConnectX-6 ×2(ib0/ib1 → bond) · LID 12/11 · 배포판 내장(inbox) verbs · Lustre 2.15.8(ZFS 백엔드) |
1차 검증(CX4 VF 환경, node-a/b/c)의 구성은 2절과 3절의 실측값으로 이미 소개했습니다. 두 환경을 나란히 기억해 두면 “같은 소프트웨어가 하드웨어 조합에 따라 어디까지 열리는지”라는 이 시리즈의 기준선이 보입니다.
부품별 교차 참조
각 부품의 원리는 앞 절들에서 이미 다뤘습니다. 검증 환경과 절을 잇는 지도가 아래 표입니다.
| 부품 | 검증 환경에서의 모습 | 자세히 |
|---|---|---|
| RDMA NIC (HCA) | ConnectX-4(EDR 100Gb/s)부터 ConnectX-6(HDR 200Gb/s)까지 — 어느 쪽도 mlx5 드라이버(mlx5_0/mlx5_1) | 1절 · 2절 |
| SR-IOV VF | node-a는 PVE 호스트 PF에서 받은 VF 2개 — 링크 타입 IB 고정 | 3절 |
| GPU | RTX A6000 + CX6 네이티브 IB — GPU-direct 실증. 제약은 NIC(VF/세대) | 4절 |
| GPU-direct 경로 | GPU↔NIC PCIe Gen4 ×16 · 위상 PHB · BAR1 256 MiB(192 MiB OK / 224 MiB 실패) · peermem GPU HBM 등록 64 MiB | 4절 · 그림 6 |
| 스위치 · SM | 무손실 크로스바 패브릭 — LID 13/12/11(SM lid 8) | 5절 |
| 케이블 · 커넥터 | QSFP28 폼팩터 — 링크 MTU 4096(전 노드 일치) | 6절 |
실측 흔적 로그
구성표의 숫자가 어디서 왔는지, 로그 수준의 흔적 세 가지로 남아 있습니다.
① peermem — gpu-1의 로그에
nvidia_peermem is enabled·register with RDMA success mr_size: 67108864(GPU HBM 64 MiB RDMA 등록 — 4절 그림 6의 파란 경로). ② BAR1 — “BAR 1 size detected via NVML API: 256 MiB”. 192 MiB 전송 OK, 224 MiB부터 실패. H100(BAR1 128 GiB)급은 해당 없음 — 전송 크기 ≤ BAR1 여유. ③ 패브릭 지문 — LID gpu-1 = 13 · stg-node1/2 = 12/11 · SM lid 8, active_mtu 전 노드 4096 일치(5절). 네이티브 IB라 유효 GID는 idx0 하나뿐이다(2편).
요약하면 — 검증 환경의 하드웨어는 ConnectX-6과 네이티브 IB 패브릭이라는 평범한 조합이었고, 특별한 신형 NIC도 RoCE 전용 패브릭도 없었습니다. 그 평범함 위에서 CX6 네이티브 IB와 RTX A6000(BAR1 256 MiB)의 조합으로 GPU-direct 경로까지 실증했습니다(4절). 1편이 보여준 것은 그 부품들이 각자 어떤 원리로 무손실·저지연 전송을 떠받치는지입니다.
마무리 — 핵심 요점
- RDMA의 성능 약속은 하드웨어가 지킨다 — HCA가 QP와 MTT를 카드 안에 직접 보관하고 커널을 우회한다.
- ConnectX-4 이후는 세대와 무관하게 mlx5 공통 드라이버 — 디바이스명
mlx5_N은 PCI 탐색 순서일 뿐이다. - SR-IOV VF는 PF에서 잘린 분할 자원 — 세대·기능·Device ID를 전부 상속하며, 링크 타입도 예외가 아니다.
- GPUDirect의 관문은 BAR1과 peermem — RTX A6000 실측으로 확인된 경계는 “전송 크기 ≤ BAR1 여유”.
- IB 패브릭은 무손실이 설계 전제 — credit 흐름제어가 드롭을 막고, SM이 LID와 LFT로 길을 끊어준다.
- QSFP의 4레인 집선과 MTU 4096 — “빠름”의 최종 구현은 결국 커넥터 접점의 전기 신호다.
다음 편 예고: RDMA 학습 시리즈 (2/7): 패브릭과 전송 프로토콜에서는 이 패브릭 위에서 움직이는 전송 프로토콜 — RC 서비스 레벨, QP, 그리고 주소 체계(GID·LID) — 로 내려갑니다.
사진 출처
본문의 실물 하드웨어 사진 8장은 모두 Wikimedia Commons에서 가져왔으며, 각 라이선스를 따릅니다.
| 사진 | 원본 | 작가 | 라이선스 |
|---|---|---|---|
| 그림 2 — HCA 실물 | Supermicro AOC-UIBQ-M2 dual port InfiniBand HCA | Dmitry Nosachev | CC BY-SA 4.0 |
| 그림 5 — Pleiades 슈퍼컴퓨터 | NASA Pleiades Supercomputer | Steve Jurvetson | CC BY 2.0 |
| 그림 8 — IB 스위치 | Infiniband switch & cables | ChrisDag | CC BY 2.0 |
| 그림 9 — CX4 케이블 | InfiniBand-CX4-Cable | Stefan Worm | CC BY-SA 3.0 |
| 그림 11 — 트윈액스 케이블 | 40Gb QSFP+ copper twinax cable | Dmitry Nosachev | CC BY-SA 4.0 |
| 그림 12 — 분해 QSFP 트랜시버 | Disassembled QSFP transciever | Dragon Sully | CC0 |
| 그림 13 — IB 케이블 다발 | Cables Infiniband | Javils00 | CC0 |
| 그림 14 — IB 포트 클로즈업 | Infinibandport | おむこさん志望 | CC BY 2.5 |


게이트웨이 On-promise 제품 팀에서 시스템 모니터링 및 관리를 쉽게 다가갈 수 있도록 하기 위한 업무를 하고 있습니다.
Contact: lhjnano@gmail.com